
2026年10月7日,星期三。上海早高峰的一辆无人驾驶出租车里,乘客低声说了一句:“前面堵得厉害,改走滨江大道吧。”语音助手几乎零延迟地理解了这句话,并在导航地图上划出一道新的弧线。
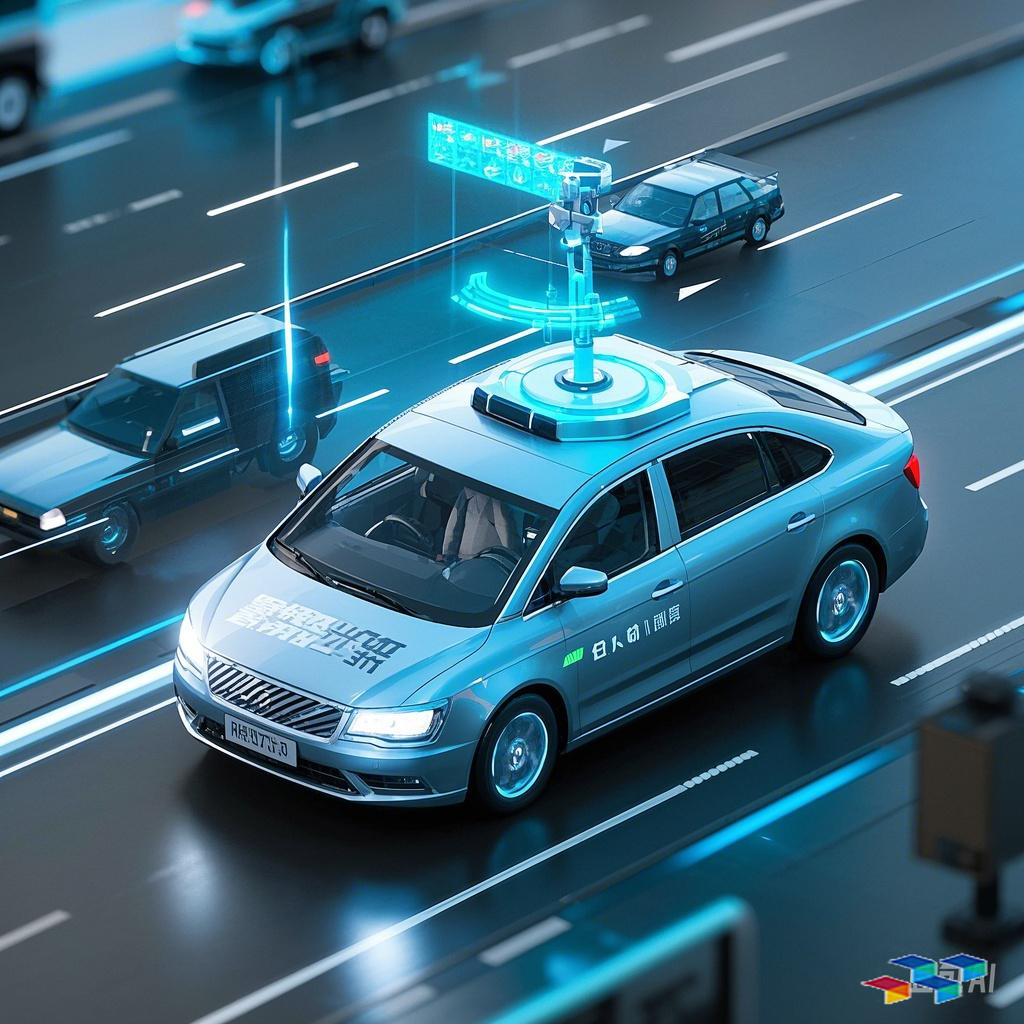
这在过去并不容易——道路颠簸、轮胎摩擦、风噪、发动机振动……所有混在一起,足以让最先进的语音识别模型抓狂。但今天,真正让这辆车“听懂”的,不只有麦克风,还有一个藏在底盘里的小器件:惯性测量单元(IMU)。
当语音识别拥有了“前庭系统”
IMU,负责测量物体的加速度和角速度。它不像麦克风那样记录声音,却能感知车辆最细微的物理动态:过减速带的撞击、急转弯的侧倾、坑洼路面的连续颠簸。
在传统的汽车语音方案里,IMU数据和语音识别是两条平行线:前者服务于底盘控制,后者服务于座舱交互。但阿里云语音识别模型团队正在做一件打破常规的事——把IMU数据接入语音识别模型的输入流,让AI在“听”声音的同时,也能“感受”路况。
原理并不复杂:当车辆驶过颠簸路面时,IMU信号会捕捉到高频振动,模型据此推断出此刻必然存在低频路噪干扰,于是自动调整注意力权重——将声学特征的焦点集中到人类语音的基频范围,降低对机械振动的响应。简单来说,模型不再只是“听到”噪声,而是“预判”了噪声。
双流Transformer:让“耳”和“前庭”对话
这一思路在模型架构层面,表现为一个跨模态的双流Transformer。
其中一条流处理语音数据(mel谱图或MFCC),另一条流处理IMU时间序列。两条流在特定层完成跨模态注意力交互:运动特征告诉声学特征“当前处于什么物理状态”,声学特征告诉运动特征“这种状态下可能产生怎样的声学干扰”。通过多轮交互,模型学会了在不同驾驶场景下动态重构语音表征。
实验数据显示,在信噪比低于10dB的车载噪声环境中,这种融合IMU信息的语音识别模型,准确率相比纯语音模型提升显著。尤其在急刹车和过减速带这两个典型场景,识别错误率几乎减半。
混合精度训练:让跨界模型跑起来
融合带来了性能,也带来了挑战。双流Transformer的参数量大,训练成本高。要让这个模型从云端实验室走向量产车,就必须把训练过程“压”下来。
这正是混合精度训练的用武之地。
在阿里云PAI平台上,团队使用BF16混合精度策略:对梯度、中间激活值等对精度不敏感的层使用低精度存储,对关键层保持FP32。这不仅能将显存占用减少一半以上,还能在模型收敛速度上取得显著加速——跨模态模型端到端训练时间压缩到原来的约三分之一。
更关键的是,这一训练流程已被阿里云封装为开箱即用的工具包。
在线课程:让更多人学会“造耳朵”
单一的技术突破并不够,产业的落地需要更多参与者。阿里云联合多所高校推出的在线课程《AI+无人驾驶:从IMU到语音识别实战》,正是为了降低这一跨界技术的入门门槛。
在课程中,学生可以下载模拟的IMU轨迹数据和车载语音语料库,在云端直接调用混合精度训练插件,亲手训练一个融合IMU的语音识别原型模型。平台上实时展示不同精度策略下的loss曲线和吞吐量变化——从数据到模型,从训练到部署,整个过程直观可见。
这门课程上线不到三个月,选课人数已突破十万。它让“无人驾驶+语音交互”不再是少数大厂的秘密,而成为整个行业可以共同学习的公开知识。
未来的汽车,有耳朵,也有前庭
回到那辆2026年的无人驾驶出租车。乘客可能并不知道,自己说出的那句“改走滨江大道”,背后经历了一次跨模态识别、一个混合精度训练过的模型,以及数以万计在线课程学习者反复训练的算法基础。
语音识别让汽车听见你,IMU让汽车感受到路,混合精度训练让这一切成为可能。当耳、眼、前庭和大脑被真正打通,无人驾驶才不只是“会开车”,而是真正“懂人、懂路、懂世界”。
而这,或许就是AI落地最迷人的地方。
作者声明:内容由AI生成
